
XenServer® エンタープライズ リファレンスアーキテクチャ
概要
このリファレンスアーキテクチャは、エンタープライズ規模のワークロードをサポートするためにXenServerを設計、展開、運用するための推奨アプローチを定義しています。これは、スケーラビリティ、回復性、運用上のシンプルさに重点を置き、Citrix Virtual Apps and Desktops™ (CVAD) 環境のホスティングだけでなく、一般的なサーバー仮想化のための検証済みの基盤を提供します。
このアーキテクチャは、XenServerリソースプールをスケールと管理のコアユニットとする概念を中心に構築されています。各リソースプールは、単一のデータセンター(または密接に接続されたデータセンターのセット)内で動作するように設計されており、予測可能で高性能なワークロード実行をサポートします。展開は、追加のリソースプールを追加することで水平方向にスケールし、増大する容量と組織の要件を満たすことができます。
設計原則
以下の原則は、設計アプローチを要約したものです。
-
スケールの単位としてのリソースプール: 明確に定義されたリソースプール内でワークロードを展開および管理し、追加のプールを追加することで水平方向にスケールする
-
設計によるワークロード分離: 特定のワークロードタイプにリソースプールを合わせ、一貫したパフォーマンスと運用動作を確保する
-
N+1キャパシティモデル: ワークロードの可用性に影響を与えることなく、単一ホストの障害を許容できる十分な容量を維持する
-
関心の分離: パフォーマンス、回復性、セキュリティを確保するために、管理、VM、ストレージトラフィックを明確に分離する
-
明示的な回復性戦略: データセンター内回復性とデータセンター間災害復旧を、別個のアーキテクチャ上の懸念事項として扱う
-
運用上のシンプルさ: 明確な価値を提供する場所にのみオプション機能を導入し、不必要な複雑さを避ける
これらの原則を合わせることで、スケーラブルで回復性があり、運用が簡単なXenServer環境を設計するための一貫したフレームワークが提供され、進化するワークロードと組織の要件にも適応し続けることができます。
このアーキテクチャは、リモートブロックストレージ、Active Directoryを介した統合ID管理、およびTLSを介したセキュアな管理の使用を前提としています。ワークロードバランシング (WLB)、高可用性 (HA)、災害復旧 (DR) などのオプション機能は、ワークロード要件に基づいて組み込むことができますが、それぞれが追加の運用上の考慮事項をもたらし、明示的に計画する必要があります。 このリファレンスアーキテクチャは、予測可能なパフォーマンスと強力な運用制御を必要とするエンタープライズ環境を対象としています。非常に大きな個々のVMディスク(2 TB超)やGPU集約型ワークロードなどの特殊なシナリオには最適化されておらず、代替設計や適応が必要になる場合があります。
全体として、このドキュメントは設計ガイドと運用フレームワークの両方として機能し、組織がXenServerを一貫性のあるサポート可能な方法で展開できるようにするとともに、時間の経過とともにプラットフォームを拡張および進化させる柔軟性を維持します。
前提条件と範囲
このアーキテクチャは、規模、インフラストラクチャ、および運用プラクティスに関する一連の基本的な前提に基づいています。
-
使用されるすべてのハードウェアは、XenServer の ハードウェア互換性リスト (HCL) に記載されている必要があります。
-
各リソースプールは最大 1,000 台の仮想マシンをサポートすることが想定されており、全体的なデプロイメントは、単一のプールを無期限に拡張するのではなく、追加のプールを追加することでスケールし、最大 200 のプールまで対応します。プール内のすべてのホストは、密接に結合されたネットワーク境界内で動作し、共有ストレージへの一貫した信頼性の高いアクセスを保証すると想定されています。
-
ホストは、必要なワークロードとコントロール ドメインをサポートするのに十分な RAM を備えている必要があり、パフォーマンス キャッシュ要件 (「リソースプールのサイジング」を参照) を含め、最大 6 TB まで対応します。
-
ホストは、XenServer OS 用のローカルストレージ (最小 46 GB、理想的には 70 GB) を備えているか、SAN から起動できる必要があります。
-
ホストは UEFI ファームウェアを使用する必要があります。XenServer 9 ではレガシー BIOS はサポートされていません。
-
-
ストレージは、リモートのブロックベースシステムを介して提供されると想定されており、XenServer は LVM ベースのストレージリポジトリを使用します。効率性と回復性は、主に基盤となるストレージプラットフォームによって提供され、使用時のアクティブな割り当てを可能にするシンプロビジョニングやマルチパスなどの機能が含まれます。継続的で信頼性の高いストレージ接続は、重要な要件です。
-
ネットワークは、管理、仮想マシン、ストレージトラフィック間の厳密な分離モデルに従います。これを実現するために、ホストは最低でも 2 つの NIC と 2 つのファイバーチャネル接続、または 4 つの NIC を備えている必要があります。この分離は、ボンディングされたネットワークインターフェースと組み合わされて、回復性とスループットを提供し、不要な依存関係やパフォーマンスの制約を導入する構成を回避します。
-
セキュリティとIDは、設計に不可欠なものとして扱われます。管理通信は TLS を使用して保護され、認証とロールベースのアクセス制御には Active Directory との統合が想定されています。管理アクセスは、標準的なエンタープライズセキュリティプラクティスに従い、ローカルアカウントの使用を制限し、管理インターフェースの公開を制御することが期待されます。
-
運用上、リソースプールは N+1 容量モデルを中心に設計されており、ホストのメンテナンス中や単一ホストの障害発生時でもワークロードが継続して実行できるようにします。サポート性とセキュリティを維持するために、更新とアップグレードは定期的に適用されることが期待されます。災害復旧が必要な場合は、シームレスまたは完全に自動化されたフェイルオーバー機能としてではなく、調整された運用プロセスとして実装されます。
オプション機能は必要に応じて組み込むことができますが、デフォルトでは想定されていません。これらには以下が含まれます。
-
ワークロードバランシング (WLB)
-
ワークロードのハイアベイラビリティ (HA)
-
データセンター間のディザスタリカバリ (DR)
それぞれが運用上の複雑さを増し、明確なワークロードとビジネス要件に基づいて採用されるべきです。
範囲外
このリファレンスアーキテクチャは、すべてのシナリオ向けに設計されているわけではなく、普遍的なソリューションとして扱われるべきではありません。特に、以下の点には直接対応していません。
-
個々の仮想ディスクが2TBを超えるワークロード
-
GPUアクセラレーションまたはGPU依存のワークロード
-
地理的に分散したデータセンター間で、シームレスなアクティブ/アクティブなワークロードモビリティを必要とするアーキテクチャ
これらの場合でも、この設計の要素は適用可能である可能性がありますが、追加のアーキテクチャ上の考慮事項と適応が必要になります。
定義
このリファレンスアーキテクチャの読解と理解を助けるための用語と定義。
| 用語 | 定義 |
|---|---|
| データセンター | 互いに近接して配置され、リモートストレージにアクセスできる、ネットワーク化されたコンピューティングの集合体。すべての接続は、低遅延、高帯域幅、高信頼性であることが期待されます。特に、XenServerホストはストレージへの接続を失ってはなりません。コンピューティングは、データセンター内の障害に対して回復力を持つように構成でき、他のデータセンターの災害復旧ソリューションの一部を形成できますが、通常運用中はスタンドアロンデプロイメントとして動作することが期待されます。これは、より広範な回復力フットプリントを形成するために、データセンター外へのワークロードの定期的な移行が想定されていないことを意味します。データセンター内にデプロイされたリソース間のネットワーク相互接続は、<2 msの遅延と>=10 Gbpsのネットワークスループットを持つことが期待されます。 |
| 近接データセンター | 低遅延、高帯域幅、高信頼性の相互接続を備えた複数のデータセンターで、単一の論理データセンターであるかのように動作することが期待されます。これらのデータセンター全体にデプロイされたリソース間のネットワーク相互接続は、<5 msの遅延と>=10 Gbpsのネットワークスループットを持つことが期待されます。 |
| 地理的に分散したデータセンター | 互いに大きく離れたデータセンター。このようなデータセンターは、それぞれ独自のネットワークとストレージを持ち、独立したエンティティとして運用されることが想定されています。 |
| アップグレード | 主要な製品バージョンの変更(例:XenServer 8.4からXenServer 9へのアップグレード) |
| 更新 | XenServerの特定の単一バージョン内でパッケージをインストールし、追加機能、バグ修正、セキュリティ修正を提供すること。 |
| リソースプール(しばしばプールと略される) | ホストをグループ化し、ホストセット全体でストレージとネットワークを管理するための単一のポイントを提供する管理単位です。詳細については、リソースプールを参照してください。 |
アーキテクチャの設計図
リソースプールに関する期待事項は以下のとおりです。
-
各リソースプールは、最大1000台の実行中のVMに対応するように設計されています。
-
各リソースプールは、単一のデータセンター内、または近接する複数のデータセンターに完全に配置されます。
-
各リソースプールは、可用性とパフォーマンスに関してすべてのワークロードが同様の特性を持つ、特定のユースケースに対応します。小規模な展開では、複数のユースケースを混在させることも可能ですが、リソースプールの負荷分散と障害モードを考慮する際には注意が必要です。
単一ユースケースの例は次のとおりです。
-
CVAD展開用の仮想デスクトップ
-
CVAD展開用のアプリケーションサーバー
-
CVADインフラストラクチャ
-
一般的なサーバー仮想化ワークロード
各リソースプールには、以下の属性があります
-
すべてのリモートブロックストレージにLVMプロトコルを使用します。GFS2プロトコルの使用は推奨されません。
-
プールコーディネーター管理のための高可用性
-
すべての管理通信にTLS 1.2を使用
-
オプション: ワークロードVMのワークロードバランシング (WLB)
-
オプション: ワークロードVMの高可用性 (HA)
-
オプション: ディザスタリカバリ (DR)
-
オプション: XenServer Conversion Managerがインストールされていること
注:
この設計は、データセンター内またはデータセンター間で複数のリソースプールを作成することで拡張でき、必要な場所にワークロードを提供できます。
各リソースプールは、以下のセクションで定義されているとおりに構築してください。
コアリソースプールの構成
新しいリソースプールを構築する際、ベストプラクティスは、必要なネットワークおよびストレージ構成を持つスタンドアロンホストを構成し、その後、他のホストをこのプールに追加することです。追加されたホストは、リソースプールに追加されると構成を取得します。
ロールベースのアクセス制御を構成する
すべてのリソースプールを信頼されたActive Directoryドメインに接続し、ADユーザーとグループを簡単に管理および監査できるようにし、XenServerリソースプールへのアクセスと権限を制御します。
注:
AD資格情報(例:ADドメインコントローラーの障害)を介して認証できない緊急時を除き、管理にデフォルト(root)アカウントを使用しないでください。
ホストの証明書プロビジョニング
すべてのリソースプール内のすべてのホストは、管理ネットワークで使用するためのプロビジョニングされたTLS証明書を持つ必要があります。CVADワークロードの場合、ホストはDNSでFQDNによって解決可能である必要があります。
すべてのホストには証明書がプロビジョニングされている必要があります。これは共有ワイルドカード証明書でも、ホストごとの証明書でも構いません。
注:
XenServer APIを使用する一部のアプリケーション(Citrix Apps and Desktopsの古いバージョンなど)では、ホストごとに個別の証明書を使用する必要があり、ワイルドカード証明書の使用は許可されていません。詳細については、関連ドキュメントを参照してください。
リソースプールへのサードパーティ接続は、TLSとFQDNを使用してリソースプール内のホストにアクセスする必要があります。
リソースプールへの通信の保護
-
ポート80を無効にする
-
管理ツールスタックが失敗した場合にSSHが自動的に有効になるように、SSHを自動モードに設定します。
セキュアブートを有効にする
XenServer 9ホストは、ファームウェアでセキュアブートを有効にして実行するように構成できます。これにより、ブートプロセスの各段階で署名検証が強制され、ホストオペレーティングシステムが完全にロードされる前に、信頼できないまたは悪意のあるコードが実行されるリスクが軽減されます。
各ホストのファームウェア設定でセキュアブートを有効にします。XenServer 9のすべてのDom0カーネルモジュールは署名されているため、標準のホスト操作には影響しません。一部のホストでセキュアブートが有効になり、他のホストで無効になっている混合プールもサポートされています。
完全な構成手順については、「XenServer 9のセキュアブート」を参照してください。
リソースプールネットワーク構成
以下のネットワークには分離が必要です。
-
管理ネットワーク
-
VMネットワーク
-
ストレージネットワーク(ネットワークベースのストレージを使用する場合)
この分離は、個別のNICを使用するか、同じNICを使用してVLANを使用することで提供できます。ネットワークベースのストレージを使用する場合は、パフォーマンス上の理由から個別のNICを使用することを強くお勧めします。
管理ネットワークとVMネットワーク
管理ネットワークとVMネットワークは、冗長性とスループットを提供するために、ボンディングされたNICで運用する必要があります。
接続損失への最適な応答を確保し、帯域幅の可用性を最大化するために、可能な限りLACPボンディングとして構成する必要があります。これには、スイッチが一致する構成で構成されている必要があります。スイッチがLACPをサポートするように構成できない場合、アクティブ-アクティブはVMネットワークに有益です。管理ネットワークは、影響なくアクティブ-パッシブを使用できます。詳細については、「ボンディングの種類」を参照してください。
可能な限り、スイッチはNICに相互接続して、ネットワーク転送における単一障害点がないことを確認し、個別の電源または冗長電源を使用する必要があります。詳細については、ネットワークのベストプラクティスを参照してください。
プール内のすべてのホストは、管理ネットワーク上に固定IPアドレスを持っている必要があります。XenServerは、DHCPによって発行されたホストIPアドレスが変更されるシナリオはサポートしていません。固定DHCPアドレスを使用する場合、DHCP環境は確実に利用可能であると想定されるべきであり(例:ネットワークインフラストラクチャの一部として)、そのDHCPサーバーに依存するホスト上で実行されているVMによって提供されるべきではありません。インフラストラクチャには静的アドレス指定が推奨されます。
すべてのホスト管理ネットワークは、クロックが同期された状態を保つために、同期されたNTPサーバーへの接続を許可する必要があります。これは、クロックドリフトが発生せず、通信パスが切断されないように、ロールベースのアクセス制御のためにコンピューターおよびユーザーアカウントを提供するActive Directoryで使用されるものと同じ時刻ソースであるべきです。これにより、すべてのシステムログに一貫したタイムスタンプがあることも保証されます。
環境の運用を可能にするために必要な完全な接続要件は、こちらに記載されています。
ストレージネットワーク
ネットワークベースのストレージを使用する場合のベストプラクティスは、ストレージからのマルチパスサポートを使用することです。これには独立したネットワーク(つまり、異なるサブネット)が必要です。これは通常、ボンドではなく単一のNICを使用し、それぞれに適切なサブネットを構成することを意味します。詳細な推奨事項については、ストレージプロバイダーにお問い合わせください。
リソースプールストレージ構成
マルチパスは有効にする必要があります。これはすべてのホストで個別に設定する必要があり、すべてのストレージリソースに対して少なくとも2つのパスが利用可能であるべきです。これらのパスは、ネットワーク/ファイバーチャネルインフラストラクチャ全体で多様であるべきです。
LVMはシックプロビジョニングされたストレージであるため、XenServerは作成されたVMディスクに必要なストレージの全量を必要とします。これは、それらのディスクのごく一部しか使用されていない場合でも、すべてのディスクとテンプレートが利用可能な全容量を占有することを意味します。
推奨されるのは、独自のシンプロビジョニング機能を提供するSANを使用し、ストレージの効率的な使用を保証することです。SANのシンプロビジョニングは、VDIの仮想サイズ全体を事前に割り当てるのではなく、データが仮想ディスクに書き込まれるときにVDIにディスクストレージスペースを割り当てることで、利用可能なストレージをより有効に活用します。使用されるストレージの量は、SANベンダーが提供するツールを使用して管理者が注意深く監視する必要があります。
SANでシンプロビジョニングを使用している場合、ストレージ使用率の監視は重要です。SANの容量が使い果たされ、それ以上の書き込みが不可能になった場合、VMの障害やデータ破損につながる可能性があります。
Citrix®環境のワークロードをプロビジョニングするためにMCSを使用する場合、ゴールデンイメージはすべてのLUNにコピーする必要があり、処理が遅くなり、イメージプロビジョニングにかなりの時間がかかり、更新されたイメージの展開が遅れる可能性があるため、この目的のために少数の大きなLUNを使用することが推奨されます。
復元戦略
XenServerリソースプールは、そのストレージリソースとともに、単一のデータセンター内(または近接するデータセンターの集合内)で運用されます。
これらのリソースプールは、データセンター内のローカルサーバー、ストレージ、およびネットワークの障害に対して回復力を持つように構成できます。さらに、データセンターが障害を起こし、リソースプール全体が失われた場合に備えて、リソースプールを組み合わせてディザスタリカバリ機能を提供することもできます。
これらについては、以下で個別に検討します。
データセンター内のレジリエンス
データセンター内のワークロードは、以下で説明するように完全なDR構成によって保護できますが、各リソースプール内にはリソースの高可用性を確保するためのレジリエンスメカニズムがあります。これらのメカニズムは、より一般的でローカライズされた問題から保護するために、自動化され、より頻繁に使用されるように設計されています。以下の機能が利用可能です。
-
管理の高可用性(計画外の停止時の自動コーディネーター選出による)
-
ワークロードコンピューティングの高可用性(計画外の停止時のVM自動再起動による)
-
ストレージのレジリエンス(ストレージマルチパスによる)
-
ネットワークのレジリエンス(ネットワークボンディングとスイッチ構成による)
これを達成するには、リソースプールがN+1ホスト以上で動作することが期待されます。ここでNはワークロードを動作させるために必要なホストの数です。これにより、1つのホストが利用できない場合でも、リソースプールをフルキャパシティで動作させる機能が提供されます。
注記:
N+1ホスト容量により、ワークロードの停止なしにリソースプールを更新およびアップグレードでき、セキュリティ更新プログラムや機能強化を簡単に適用できます。
これらの機能は、データセンター内または近接するデータセンター間で完全に運用される、回復力の高いデプロイメントを提供します。地理的に分散したデータセンター間での回復力はサポートしません。これをサポートする唯一の方法は、以下で説明するDR機能を使用することです(データセンター間のレジリエンスを参照)。
オプション機能
ワークロードバランシング (WLB)
-
使用する場合: VMワークロードの実行中に、利用パターンが大幅に異なり、時間とともに変化し、パフォーマンスを維持するために自動的な推奨事項や再バランシングが必要な場合。
-
避ける場合: ワークロードが非常に均一である(例えば、多くの類似した非永続VDI VMなど)場合で、初期配置と通常のライフサイクル操作で既に十分なバランスが取れている場合、または移行が運用上望ましくない場合。
-
運用上の影響: 運用および監視するアプライアンスが1つ追加されます。WLB処理が利用できなくなる日次メンテナンス期間が含まれます。
WLBは、ワークロードの使用状況が時間とともに変化するにつれて、最適なホスト利用率とパフォーマンスを維持するために使用できます。
アプライアンスをリソースプールにインポートし、接続には管理ネットワークを使用します。Workload Balancing (WLB) アプライアンスは、XenServerダウンロードページからダウンロードできます。
アプライアンスのデフォルトのサイジング(2 GB RAM、30 GBディスク、2 vCPU)を使用する必要があります。
ワークロードの適合性
WLBは、VMの実行期間中にワークロードの需要が動的に変化する場合にのみ必要とされます。WLBを使用する場合、VMが停止して再度起動されるたびに、現在のワークロードに対して即座に最適に配置されるため、VMはホストの利用率が変化した場合にのみ移動が必要となります。多くの類似したVMがすべて類似したタスクを実行するユースケースでは、WLBを使用する価値はほとんどなく、初期のVM配置に頼ってワークロードバランシングを提供できます。
データベースメンテナンス期間の調整
WLBアプライアンスは毎日ルーチンメンテナンスを実行します。デフォルトでは、これはUTC 00:05に行われます。このプロセス中に最大30分間のWLB処理停止が発生するため、リソースプールの活動が少ないときに実行されるように設定する必要があります。これは通常の操作には影響せず、配置最適化の決定にのみ影響します。WLBはメンテナンスが完了するとすぐにアクションを完了します。
WLBパラメータ設定
多くの設定はデフォルトのままにしておくことができます。これにより、WLB機能は管理者に推奨事項を提示し、管理者はこれらのアクションを適用する必要があります。
このブループリントのデフォルトおよび推奨される構成では、リソースプールが最高のパフォーマンスで動作できるように、「クリティカルしきい値」と重み付けのみを調整する必要があります。これらは使用を通じて最適化できますが、いくつかの推奨される初期値は次のとおりです。
-
CPU使用率: デフォルトでは、クリティカルしきい値が90%で、最大重み付けが設定されています。これにより、ホストのCPUが過去1.5分間で平均負荷90%に達すると、WLBサービスはVMを実行するための代替場所を評価します。
-
VMのパフォーマンスが低いCPU使用率で影響を受けている場合、可能な限りホスト全体の平均CPU使用率を低い値に保つことを目的として、このクリティカルしきい値を調整できます。
-
推奨される初期クリティカルしきい値: 90%
-
推奨される初期メトリック重み付け値: 最重要
-
-
空きメモリ: ホストに空きメモリを保持することで得られる特定のパフォーマンスはありません。そのため、メモリを空けるためにマシンを移行することは、不要なオーバーヘッドです。
-
推奨される初期のクリティカルしきい値: 0
-
推奨される初期メトリック重み付け値: 最も重要度が低い
-
-
ネットワークの読み取りと書き込み: これらのデフォルト値は25 MB/sです。これは、いずれかのホストが読み取りまたは書き込みにより多くの帯域幅を使用している場合、再配置の対象となることを意味します。このパラメータは、重いネットワークワークロードを実行しているVMがあり、他のVMへの影響を回避することが重要である場合にのみ関連します。
-
多くのアプリケーションにとって、これは関連する要素ではないため、重み付けは最も重要度の低い設定にすべきです。
-
多くの最新のネットワークにとって、これは非常に低い値であり、この設定が関連する場合は、別のホストへの移行を検討する前に、この帯域幅を有効に活用できるように設定することをお勧めします。
-
推奨される初期のクリティカルしきい値: 利用可能な帯域幅の90%
-
推奨される初期メトリック重み付け値: 中程度の重要度
-
-
ディスクの読み取りと書き込み: これのデフォルト値は25 MB/sです。これは、いずれかのホストが読み取りまたは書き込みにより多くの帯域幅を使用している場合、再配置の対象となることを意味します。このパラメータは、重いディスクワークロードを実行しているVMがあり、他のVMへの影響を回避することが重要である場合にのみ関連します。リモートストレージが使用されている場合、ファブリックの帯域幅がボトルネックでない限り、これは価値がありません。なぜなら、リモートストレージへの影響は、それが動作しているホストに関係なく、そのストレージを使用するすべてのVMのパフォーマンスに影響を与えるからです。
-
ほとんどの最新のストレージとファブリックにとって、これは低い値であり、この設定が関連する場合は、帯域幅を有効に活用できるように、より高い値に設定する必要があります。これは、VMの営業時間外の定期的なメンテナンスが、不要なときに大量の移行を引き起こさないように、十分に高く設定する必要があります。
-
推奨される初期のクリティカルしきい値: 利用可能な帯域幅の90%
-
推奨される初期メトリック重み付け値: 中程度の重要度
-
リソースプールにおける高可用性 (HA)
HAの完全なドキュメントはこちらで入手できます。
XenServerの高可用性に関して考慮すべき要素が2つあります。
-
管理HA: リソースプール内のコーディネーターホストで予期せぬ障害が発生した場合に、管理操作を自動的に維持する機能
-
VM HA: リソースプール内のホストで予期せぬ障害が発生した場合に、ワークロード操作を維持する機能
これらの両方の側面は、特定のストレージおよびネットワーク構成を必要とします。これについては、以下のセクションで説明します。
利用可能なストレージLUNの1つが、XenServerハートビートSRとして選択されます (この要件の詳細については、可用性のためのハートビートを参照してください)。複数のLUNが利用可能な場合、どれが選択されても問題ありません。HA機能を提供するために、このLUNから少量のスペース(5GB未満)が割り当てられます。
このリファレンスアーキテクチャは、単一ホストの予期せぬ損失の範囲内でワークロードの維持をサポートするように設計されています。「許容する障害数」の設定は1に設定する必要があります。
注意:
HAを使用する際には、以下の特性に注意することが重要です
-
リソースプールには少なくとも3つのホストが必要です
-
フェンシングとは、障害が発生した、または安全でないと見なされるホストを強制的に隔離し、仮想マシンが別の場所で再起動される前に、そのホストが共有リソース(特に共有ストレージ)にアクセスできないようにするメカニズムを指します。リソースプールが大きいほど、ホストフェンシングの影響は大きくなり、通信パスの要件により発生する可能性が高くなります。この点に関して、\>16ホストを超えるプールについては慎重な検討が必要です。
-
これらのメンテナンス活動が実施されている間の予期せぬ停止のリスクを軽減するため、ホスト/リソースプールのメンテナンス操作中はHAを無効にする必要があります。
-
HAを使用する場合、HAステートファイルSRへのストレージ接続とネットワークが中断されないように注意する必要があります。これらの接続が中断されると、リソースプールの操作を保護するためにホストが予期せずフェンスされる可能性があります。これは、インフラストラクチャのメンテナンスを行う際には、接続が失われないように慎重に検討する必要があることを意味します。
管理HAの代替アプローチ
信頼性の高い、高可用性の管理接続を提供するためにHAを使用している場合、上記の制限を回避するために、以下の方法も検討する必要があります。
ホスト監視の実装
XenServerホストをサードパーティの監視ソリューションと統合し、ホストが応答しないときに検出します。
管理接続を手動で復旧する
連絡不能なホストがコーディネーターであり、管理操作が利用できない場合、リソースプール内の他のすべてのホストは緊急モードに入り、それらへのリモート接続が確立されて、そのうちの1つが新しいプールコーディネーターとして選出されるようになります。これはリモート言語バインディングを使用して実行できます。以下にxe CLIとPowerShellの例を示します。
xe CLI:
xe -s <server_IP> -u <username> -pw <password> host-is-in-emergency-mode                     -> Confirm election possibility
 xe -s <server_IP> -u <username> -pw <password> pool-emergency-transition-to-master           -> Designate current host as new master
 xe -s <server_IP> -u <username> -pw <password> pool-recover-slaves                           -> Reconfigure member servers to new coordinator
PowerShell:
 Invoke-XenPool -XenAction EmergencyTransitionToMaster          -> Designate current host as new master
 Invoke-XenPool -XenAction RecoverSlaves                        -> Reconfigure member servers to new coordinator
VM 高可用性
ワークロードバランシング (WLB) VM
このVMは、予期せぬ停止後にWLB機能が失われないように、再起動優先度を「再起動」に設定する必要があります。最初の起動グループ0に属している必要があります。
その他のVM
XenServerの正確な使用方法に応じて、追加のVMがVM HAを使用するように構成される場合があります。以下に、いくつかのユースケースに対する提案を示します。
意思決定ガイド (VM HA): 予期せぬホスト停止後の自動再起動がサービス継続性を大幅に向上させ、プールが停止を吸収するためにN+1でサイジングされているワークロードにはVM HAを使用します。外部のブローカー/オーケストレーションがすでに再起動またはスケールアウト動作を提供しているワークロード(例えば、多くの非永続的なCVADワークロード)や、再起動順序と依存関係の制御が難しいワークロードにはVM HAの使用を避けてください。
注:
HAが構成された後にリソースプールに追加されたVMは、デフォルトで「再起動しない」になります。必要に応じて、VMが環境に追加された後にHAを再構成する必要があります。
-
PVSおよび非永続MCS VM: これらのVMにはHAを構成しないでください。これらが
Do Not Restartに設定されていることを確認してください。他のVMはエンドユーザーに即座のサービスを提供できるように利用可能であるべきであり、Citrix Virtual Apps and Desktopsは、エンドユーザーが必要とする場合、または予想される需要をサポートするための自動スケール機能を通じて、これらのVMの再起動をサポートする電源管理機能を提供します。AutoScaleを参照してください。これにより、統合されたCitrix環境にとってより最適化された結果が得られます。 -
MCS永続VM: これらは「再起動」に設定する必要があります。設計されている構成は、1つのホストがサービス停止中(更新、メンテナンス、または停止のため)であっても、プール内のすべてのVMを動作させるのに十分なRAMとCPUが利用可能であることを保証する必要があり、これによりこの構成が可能になります。
-
一般的なサーバー仮想化ワークロード(Citrix VDAの実行に使用されていないワークロード): これらは「再起動」に設定する必要があります。設計されている構成は、1つのホストがサービス停止中(更新、メンテナンス、または停止のため)であっても、プール内のすべてのVMを動作させるのに十分なRAMとCPUが利用可能であることを保証する必要があり、これによりこの構成が可能になります。VMは、必要に応じてワークロードが再起動されるように、起動グループと遅延を使用するように構成できます。これは、Active Directory、DHCP、DNSサービスプロバイダーなど、他のサービスが依存するワークロードの優先順位付けに使用できます。
データセンター間のレジリエンス
オプション:
データセンター間の災害復旧 (DR)。このリファレンスアーキテクチャは、必要に応じてDRをサポートできますが、追加の設計および運用上の考慮事項が必要です。
DRに関する意思決定ガイダンス
-
使用する場合: サイトのレジリエンスに関する明確なビジネス要件、レプリケーション対応のストレージプラットフォーム、およびセカンダリサイトでのVMリカバリを必要とする合意済みのリカバリ手順 (RPO/RTO) がある場合。
-
避けるべき場合: サイト間で頻繁なワークロードのモビリティが必要な場合、またはフェイルオーバー/フェイルバックプロセスをテストおよび実行するための運用能力がない場合。CVADの場合、調整されたCVAD DR設計なしに、ハイパーバイザーの接続と証明書がシームレスにフェイルオーバーすると仮定しないでください。
-
運用上の影響: DRは完全に自動化されていません。フェイルオーバー/フェイルバックには、計画されたランブック、ストレージレプリケーション制御へのアクセス、および定期的なテストが必要です。
ここで説明するXenServerの災害復旧 (DR) 構成は、インフラストラクチャの極端な予期せぬ停止をサポートするために、めったに使用されない操作として想定されるレジリエンスモードです。この操作は自動化されておらず、復旧には慎重な計画と運用が必要です。DRモデルは、最適な配置ではないかもしれない一時的な場所でワークロードを運用することを可能にしますが、停止期間中の重要なビジネス運用をサポートします。
XenServer DRモデルは複雑なソリューションであり、サイト障害から保護するための他の方法もあります。たとえば、非永続VMを使用してサービスを提供するCitrixワークロードの場合、一時的なサービスを提供するために、追加のVMをリカバリサイトにプロビジョニングできます。これらのオプションは、実装が容易である可能性があるため、XenServer DR機能を使用する前に検討する必要があります。
CVADに適したDRソリューションがない限り、Citrix VDIワークロードにDRを使用することは避けることをお勧めします。ネットワークと証明書のマッピングにより信頼性が低下する可能性があるため、同じハイパーバイザー接続がXenServer DRサイトにフェイルオーバーできると仮定するのは安全ではありません。
データセンターの障害とワークロード (またはワークロードの重要な部分) の損失のリスクを軽減するために、災害復旧機能を提供するためにセカンダリデータセンターの場所を使用できます。詳細なドキュメントはこちらで入手できます。
DRサイトの1つ以上のリソースプールは、ワークロードのリカバリ場所であることに加えて、他のワークロードにも使用できますが、必要に応じて追加のワークロードを実行できるように、必要な予備容量を維持する必要があります。
障害イベントが発生した場合に、DRサイトでワークロード全体を運用する必要はありません。プライマリサイトで完全な運用が復元されるまで、部分的なワークロードを回復できますが、ワークロードは1つのリソースプールから単一のリカバリリソースプールに回復する必要があるという要件があります。ワークロードを複数のリカバリプールに分散することはできません。
重要:
プライマリサイトのLUNからDRサイトにデータをミラーリングするストレージレプリケーションプロセスは、XenServerツールセットの外部で構成する必要があり、この再構成は、フェイルオーバーを担当する管理者が利用できる必要があります。これは、このプロセスに関連する操作の一部としてミラーリングを解除およびリセットする必要があるためです (詳細については、操作セクションを参照してください)。
このデプロイメントを構築する際:
-
VM仮想ディスクに使用されるすべてのストレージは、プライマリ環境からバックアップ環境にレプリケートされる必要があります。
-
プールメタデータに使用されるすべてのストレージは、プライマリ環境からバックアップ環境にレプリケートされる必要があります。
-
DRサイトのハードウェアインフラストラクチャは、プライマリサイトと一致する必要はありませんが、同じプロセッサベンダーを使用する必要があります。必要なすべてのフェイルオーバーVMを再作成して起動できるように、十分なメモリ、CPU、およびネットワーク容量がスタンバイリソースプールに構成されている必要があります。
-
リカバリサイトのXenServerリソースプールは、プライマリサイトと同じリリースおよびパッチレベルであるか、それよりも新しい必要があります(これを実現する方法の詳細については、デプロイメント全体でのXenServerバージョン管理を参照してください)。
運用モデル
デプロイメント全体でのXenServerバージョン管理
XenServerデプロイメントは、1つ以上のリソースプールから構築され、1つ以上のデータセンターにまたがって、スケーラブルで堅牢かつ安全なデプロイメントを提供し、大規模な高性能ワークロードを実現できます。
これらのデプロイメントは、テスト環境と本番環境を提供でき、これらの環境を通じて変更を展開するためのワークフローを構築できます。
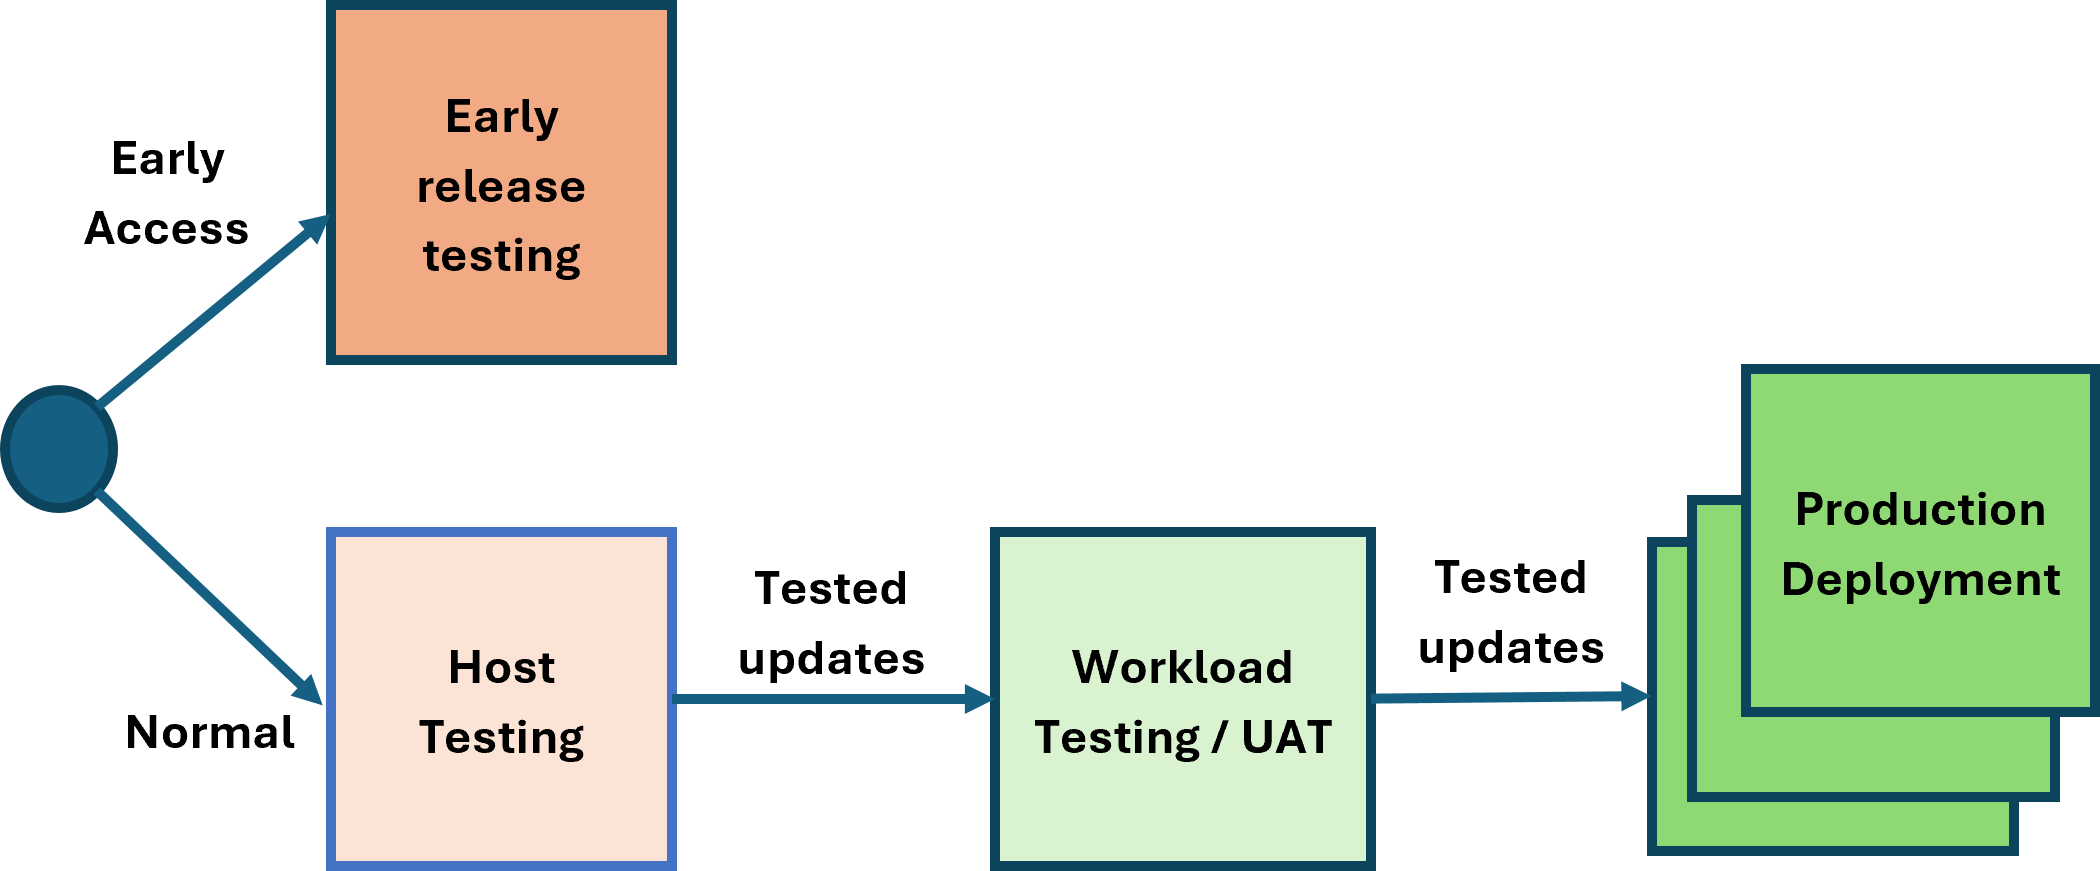
オプション:
ホストテストおよびワークロードテストのフェーズはオプションです。リファレンスアーキテクチャは、これらのフェーズの有無にかかわらず運用をサポートします。
ホストテストとワークロードテストの段階は、別々の段階である必要はなく、組み合わせることができます。これにより、変更が本番環境に到達するまでの時間を短縮できるため、有利です。XenServerの更新ストリームは堅牢で完全にテストされており、継続的なデプロイメントを可能にします。セキュリティ、堅牢性、およびパフォーマンスを維持するためには、更新が本番環境に到達するまでの時間を最小限に抑えることが重要です。
各フェーズの期待事項は次のとおりです。
-
早期リリース版テスト: このフェーズは、更新の早期可視化と機能の検証を目的としています。このフェーズのホストは、通常チャネルよりも2週間早く新しいバージョンへのアクセスを提供する早期リリースチャネルを使用するように構成されています。このフェーズのホストは、XenServerコンテンツ配信ネットワーク(CDN)にアクセスするために、インターネットへのアウトバウンド接続(直接またはプロキシサーバー経由)が必要です。
-
ホストテスト: このフェーズの目的は、XenServerソフトウェアリリース更新プロセスをテストすることです。リリースは、インターネット経由でXenServer CDNから、またはオフラインチャネル配信メカニズムを通じて入手できます。
-
ワークロードテスト/UAT: このフェーズでは、XenServerホストを本番環境に近いワークロードでテストし、スケールと回復力を検証できます。リリースは、インターネット経由でXenServer CDNから、またはオフラインチャネル配信メカニズムを通じて入手できます。
-
本番環境への展開: 本番ワークロードを実行しているホストは、以前のテストフェーズ(直接またはオフライン配信メカニズムを通じて)に従って更新できます。
注:
オフライン更新を使用すると、XenServerの予期されるバージョンがUATおよび本番環境に展開されていることを確認できます。別のリソースプールから直接更新を同期することも可能ですが、同期されていてもソースプールにまだ適用されていない更新がある場合、それらが宛先プールに適用され、宛先プールでより高いパッチバージョンになる可能性があります。
サポートを維持するためには、すべてのリソースプールを定期的に更新し、6か月以上古くならないようにする必要があります。
Driver Multi-Versioning (DMV) によるドライバー管理
XenServer 9では、Driver Multi-Versioning (DMV) が導入され、承認されたドライバーバージョンが標準のストリーミングホスト更新チャネルを通じて提供されるため、ほとんどの場合、個別のドライバーディスクは不要になります。
DMVを使用すると、オペレーターは更新ストリームで利用可能な複数の承認済みドライバーバージョンから選択できます。XenServerは、各ホストのハードウェアと互換性のあるドライバーバリアントのみを提示します。誤ったドライバーが適用された場合でも、ホストを再インストールすることなく正しいバージョンを選択してインストールできますが、変更を有効にするには再起動が必要です。XenServer 9は署名済みドライバーの検証を強制し、未承認のサードパーティ製バイナリをブロックします。
詳細については、「Driver multi-versioning」を参照してください。
リソースプールの監視
リソースプール内のいずれかのホストまたはVMでアラートが発生した場合、それらはXenCenter®の「アラート」セクションで利用できます。
これらのアラートは、SNMP統合または電子メールSMTP統合を介して、外部監視ツールでも利用できます。
考慮すべき監視には2つのタイプがあります。
-
予期せぬ容量の問題を迅速に特定し、対処できるようにするための利用状況の監視。
-
システムイベントを監視し、インフラストラクチャが正しく動作していること、および予期せぬ変更が発生していないことを確認します。
これらは、統合設計で考慮すべき点として以下に詳述されています。
サードパーティの監視製品との統合は、(/ja-jp/xenserver/9/monitor-performance/monitor-snmp.html)に記載されているSNMP機能を通じて行うことができ、これらのサードパーティツールに統合されるアラートを提供できます。
注:
プールに新しいホストを追加する際は、新しいホストがSNMP統合に含まれるようにSNMP設定を再構成する必要があります(詳細については、(/ja-jp/xenserver/9/monitor-performance/monitor-snmp.html#constraints)を参照してください)。
使用状況の監視
過剰なCPU使用率などの検出用に構成できるアラートがあります。詳細については、(/ja-jp/xenserver/9/monitor-performance/alerts.html#performance-alerts)を参照してください。
以下は、これらのイベントに対して発行されたSNMPトラップで提供されるデータの例です。
2026-02-19 09:44:35 <UNKNOWN> [UDP: [10.71.64.14]:53876->[10.81.143.35]:162]:
 iso.3.6.1.2.1.1.3.0 = Timeticks: (196826250) 22 days, 18:44:22.50       iso.3.6.1.6.3.1.1.4.1.0 = OID: iso.3.6.1.4.1.60953.1.10.1   iso.3.6.1.4.1.60953.1.10.1.1.0 = STRING: "add"  iso.3.6.1.4.1.60953.1.10.1.2.0 = STRING: "OpaqueRef:eea63153-f96c-25f5-17b9-08ce49e7ccf4"   iso.3.6.1.4.1.60953.1.10.1.3.0 = STRING: "83a9c805-a172-f1b2-55d4-081ec180893b" iso.3.6.1.4.1.60953.1.10.1.4.0 = STRING: "ALARM"    iso.3.6.1.4.1.60953.1.10.1.5.0 = INTEGER: 3     iso.3.6.1.4.1.60953.1.10.1.6.0 = STRING: "VM"       iso.3.6.1.4.1.60953.1.10.1.7.0 = STRING: "681e4064-16cb-4d0c-9c2c-887623bc623f" iso.3.6.1.4.1.60953.1.10.1.8.0 = STRING: "20260219T09:45:55Z"       iso.3.6.1.4.1.60953.1.10.1.9.0 = STRING: "The memory required by the control domain on \"Control domain on host: pm-demolab-3\" is about 5.7% of its allocated memory. Occasional performance degradation can be expected when memory swapping is forced to happen.
 This alarm is set to be triggered when the memory required by the control domain is above 5.0% of its allocated memory."
システムイベントの監視
システムアラートは(/ja-jp/xenserver/9/monitor-performance/alerts.html#system-alerts)に記載されています。
以下は、これらのイベントに対して発行されたSNMPトラップで提供されるデータの例です。
2026-02-19 09:43:39 <UNKNOWN> [UDP: [10.71.64.14]:46982->[10.81.143.35]:162]:
 iso.3.6.1.2.1.1.3.0 = Timeticks: (196820650) 22 days, 18:43:26.50       iso.3.6.1.6.3.1.1.4.1.0 = OID: iso.3.6.1.4.1.60953.1.10.1   iso.3.6.1.4.1.60953.1.10.1.1.0 = STRING: "add"  iso.3.6.1.4.1.60953.1.10.1.2.0 = STRING: "OpaqueRef:ca95e2da-06b7-9aa5-fa4b-ddf007a50c59"   iso.3.6.1.4.1.60953.1.10.1.3.0 = STRING: "525e459c-51bc-c71c-9c52-dcd747e9a84f" iso.3.6.1.4.1.60953.1.10.1.4.0 = STRING: "ALL_RUNNING_VMS_IN_ANTI_AFFINITY_GRP_ON_SINGLE_HOST"      iso.3.6.1.4.1.60953.1.10.1.5.0 = INTEGER: 3iso.3.6.1.4.1.60953.1.10.1.6.0 = STRING: "Pool"  iso.3.6.1.4.1.60953.1.10.1.7.0 = STRING: "419d6735-5d11-56b1-8cdc-2853ce709a27"     iso.3.6.1.4.1.60953.1.10.1.8.0 = STRING: "20260219T09:44:59Z"   iso.3.6.1.4.1.60953.1.10.1.9.0 = STRING: "<body><message>Breach on VM anti-affinity rules</message><VM_group>3224f9d9-9492-06f7-3c92-da610cde33a8</VM_group><host>ce2a3c26-6bbc-4d23-8626-fba28d3dc651</host></body>"
リモートロギング
これの主な目的は、サポートエンゲージメントを可能にすることです。問題解決中にこのデータの可用性を確保するために、syslog転送を構成できます。これにより、ホストから直接ログを取得できない場合、またはホスト上のログが改ざんされた疑いがある場合に、ログを取得できるようになります。
これが構成されている場合、プール内のすべてのホストで構成する必要があります。
このデータはかなりのスペースを消費する可能性があります。この機能とデータの使用および保持は、内部セキュリティポリシーに基づいてお客様の裁量に委ねられます。
キャパシティプランニングモデル
リソースプールのサイジング
各リソースプールには、ホストが1台ダウンしてもリソースプールがフルワークロードで動作できる十分なリソースが含まれている必要があります。これにより、以下が可能になります。
-
一度に1台のホストで計画的な停止を必要に応じて実行できる
-
ワークロードの停止なしにリソースプールの更新を行える
-
ホストが1台予期せず障害を起こした場合でも、ワークロードの停止を最小限に抑える
これを達成するためには、リソースプール内のすべてのホストがワークロードをサポートする同じ能力を持っていること(つまり、同じ構成、RAM、CPU)が期待されます。これにより、停止中にCPUのオーバーコミットレベルが高くなる可能性がありますが、これは停止状態が解決されるまでの一時的なものと想定されます。
リソースプール内で2台以上のホストが失われた場合、すべてのワークロードを維持することはできなくなり、ホストが復旧するまでワークロードの停止が発生する可能性があります。
注記:
ハードウェアの更新/リフレッシュなどのアクティビティ中に、ホストが一時的に同一の容量を持たない場合、最もメモリの多いホストの障害に備える必要があります
リソースプールの容量計算
このリファレンスアーキテクチャでは、各リソースプールが特定の目的のためにあると仮定しています。その結果、以下の計算では、リソースプール内のすべてのVMが同じ仕様であると仮定しています。
NUMA最適化
XenServer 9は、デフォルトでNUMA配置最適化を有効にしています。VMのvCPUとメモリがホスト上の単一のNUMAノード内に収まる場合、ワークロードはメモリアクセスレイテンシを低減し、より一貫したパフォーマンスを実現します。これにより、ホストあたりのVM密度を高めることもでき、追加のサーバーの必要性を減らします。
最良の結果を得るには、VMのメモリが単一の物理NUMAノード内に収まるようにVMをサイジングしてください。VMが単一ノードで提供できる以上のメモリを必要とする場合、XenServerはVMを複数のノードに分散させ、最適化のメリットが減少します。NUMAノードの境界を超えるVMサイジングは、標準ではなく例外として扱うべきです。
VMごとのNUMAメトリックは、配置を監視し、アフィニティ違反を検出するために利用できます。詳細については、XenServer 9でのNUMA最適化を参照してください。
リソースプール容量の計算
Dom0のサイズは32 GB RAMです。ただし、PVSアクセラレータを使用している場合、アクセラレーションをサポートするためにvdiskあたり少なくとも5 GB増やす必要があり、これらの計算で考慮に入れる必要があります。
入力
| 用語 | 定義 |
|---|---|
host_ram |
各ホストの合計RAM (GB単位) |
vm_ram |
各VMに必要なRAM (GB単位) |
host_cpus |
ホストで利用可能なvCPUの数 (これらは論理CPUであるため、スレッドを含む) |
vm_cpus |
各VMに必要なvCPU |
hosts_total |
プール内のホスト数 |
vm_disks |
各VMに接続されているディスク数 |
vm_snapshots |
VMあたりの予想スナップショット数 |
dom0_ram |
Dom0用に予約されたメモリ (このリファレンスアーキテクチャでは32 GB) |
dom0_vcpus |
Dom0用に予約されたvCPU (このリファレンスアーキテクチャでは16) |
wlb_ram |
WLBアプライアンスに必要なメモリ (このリファレンスアーキテクチャでは2GB) |
wlb_vcpus |
WLBアプライアンスに必要なvCPU (このリファレンスアーキテクチャでは2) |
出力
| 用語 | 定義 | 計算式 |
|---|---|---|
vm_host_max |
プール内の各ホストで実行されるVMの最大数 | (host_ram - dom0_ram - wlb_ram) / vm_ram |
vm_pool_max |
プールで実行可能なVMの最大数 | vm_host_max * (hosts_total - 1) |
srs_total |
VMをホストするために必要なストレージリポジトリの数 | vm_pool_max * (vm_disks + vm_snapshots) / 1000 |
vm_host |
ホストで実際に実行されているVMの数 | vm_pool_max / hosts_total (注を参照) |
host_cpu_overcommit |
ホストで必要なワークロードを実行するために必要なvCPUの数(これらは論理CPUなのでスレッドを含む) | ((vm_host * vm_cpus) + dom0_vcpus + wlb_vcpus) / host_cpus |
注:
ホストの障害、メンテナンス、または更新操作中に
vm_host = vm_pool_max / (hosts_total - 1)
実施例
| 用語 | 値 |
|---|---|
host_ram |
1000 ギガバイト (1 テラバイト) |
vm_ram |
16 GB |
host_cpus |
32スレッドコアを持つ2つのソケット = 2 * 32 * 2 = 128 |
vm_cpus |
4 |
hosts_total |
8 |
vm_disks |
MCS VM = IDディスク 1、OSディスク 1、MCSIOディスク 1 = 3 |
vm_snapshots |
0 |
dom0_ram |
32 |
dom0_vcpus |
16 |
wlb_ram |
2 |
wlb_vcpus |
2 |
-
vm_host_max = (1000 - 32 - 2) / 16 = 60 max VMs per Host -
vm_pool_max = 60 * (8 - 1) = 420 max VMs per pool -
srs_total = 420 * (3 + 0) / 1000 = 1.26 SRs (>1 so need 2 SRs spread over 2 LUNS) -
通常運用時:
-
vm_host = 420 / 8 = 52.5 VMs per host (round down to 52) -
host_cpu_overcommit = ((52 * 4) + 16 + 2) / 128 = 1.77 vCPU per pCPU
-
-
単一ホストの停止時、または更新/メンテナンス操作時:
-
vm_host = 420 / 7 = 60 VMs per host -
host_cpu_overcommit = ((60 * 4) + 16 + 2) / 128 = 2.01 vCPU per pCPU
-
注:
RAMのオーバーコミットを提供するために、動的メモリ制御 (DMC) は使用されません。XenServerは通常運用中にこれをサポートしていません。これは、必要なワークロードを実行し続けるための他のオプションがない場合に、計画的で制御された短期間のメンテナンス中にのみ使用されることが想定されています。
オーバーコミットが高すぎる場合、プール内のVMの数を許容できるレベルに達するまで減らす必要があります。