
XenServer 9 中的 NUMA 优化
概述
非统一内存访问 (NUMA) 是一种多处理器内存架构,其中内存被划分为连接到特定 CPU 插槽的节点。访问本地 NUMA 节点上的内存比访问远程节点上的内存具有更低的延迟。当虚拟机 vCPU 及其内存位于同一 NUMA 节点上时,工作负载可以实现更低的内存访问延迟和更好的性能。
UMA 与 NUMA 比较
-
UMA(统一内存访问)主机向 CPU 呈现单个物理内存节点。
-
NUMA 主机公开多个内存节点。CPU 在访问其本地节点上的内存时比访问远程节点上的内存具有更低的延迟。
优化 NUMA 放置的优势
-
提高应用程序响应能力和工作负载吞吐量。
-
每个主机的虚拟机密度更高,减少了对额外主机的需求并降低了总体基础设施成本。
限制
-
如果主机上没有单个 NUMA 节点有足够的空闲内存供虚拟机使用,XS9 会将虚拟机的内存分散到多个节点上以允许虚拟机启动。
-
当内存分散时,虚拟机使用多个 NUMA 节点 (
NUMA nodes > 1) 并且未进行 NUMA 优化。 -
性能改进因工作负载、基准测试和 CPU 类型而异。
监控和故障排除
每个虚拟机的 RRD 指标(默认禁用)有助于监控 NUMA 行为和 vCPU 调度。
指标
-
NUMA 节点 (
numa_nodes): VM 使用的 NUMA 节点数量。值为 1 表示已优化;值大于 1 表示未优化。 -
内存 NUMA 节点 X (
memory_numa_node_X): 从物理 NUMA 节点 X 分配的 VM 内存量。值为 0 表示未从该节点分配内存。 -
vCPU 可运行(任意) (
runnable_any): 至少一个 vCPU 已就绪但没有可用的 pCPU 的时间百分比。这是 CPU 争用的早期指标。 -
vCPU 可运行(总和) (
runnable_vcpus): 由于调度延迟导致所有 vCPU 的预期减速百分比。 -
NUMA 非亲和性 vCPU (
numa_node_nonaffine_vcpus): vCPU 在与 VM 内存不在同一 NUMA 节点上的 pCPU 上运行的时间百分比。值越高表示内存访问延迟越大。
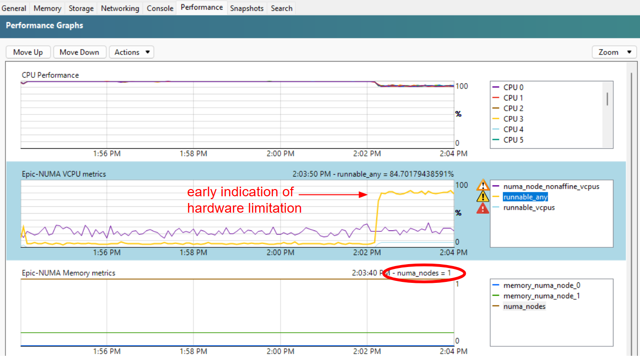
调试清单
-
检查
NUMA nodes以查看 VM 使用了多少个 NUMA 节点。 -
检查
vCPUs runnable any以了解域级调度争用情况。 -
检查
vCPUs runnable sum以了解 vCPU 级调度延迟情况。 -
检查
NUMA non-affine vCPUs以了解 NUMA 亲和性违规和相关延迟情况。
启用指标并导出样本
默认情况下,每个 VM 的 RRD 指标处于禁用状态。要为 VM 启用指标(例如,
runnable_any)并导出样本,请执行以下操作:
# Enable the data source for a VM
 xe vm-data-source-record uuid=<vm-uuid> data-source=runnable_any

 # Export sample RRD output
 rrd2csv VM:AVERAGE::runnable_any
配置 NUMA 放置 (xe CLI)
NUMA放置优化在XS9主机上默认启用。无需采取任何操作即可将其开启。
要在主机上禁用NUMA放置优化,请将主机NUMA亲和性策略设置为
any。
# View current policy
 xe host-param-get uuid=<host-uuid> param-name=numa-affinity-policy

 # Disable optimization
 xe host-param-set uuid=<host-uuid> numa-affinity-policy=any

 # Verify
 xe host-param-get uuid=<host-uuid> param-name=numa-affinity-policy
默认启用时,策略值为
default_policy。禁用时,值为any。